FileKit 制作记:用 Canvas 和 pdf-lib 做纯前端文件处理,为什么值得零上传,以及它在格式支持、内存和批量下载上的限制。
周五下午,同事在群里发来两份合同 PDF,让我合成一份发回去。我打开浏览器搜「PDF 合并」,第一个站点的流程是:选文件、上传、等进度条、下载。两份合同,几百 KB,要完整经过一台陌生服务器。我关掉页面,决定自己写一个。
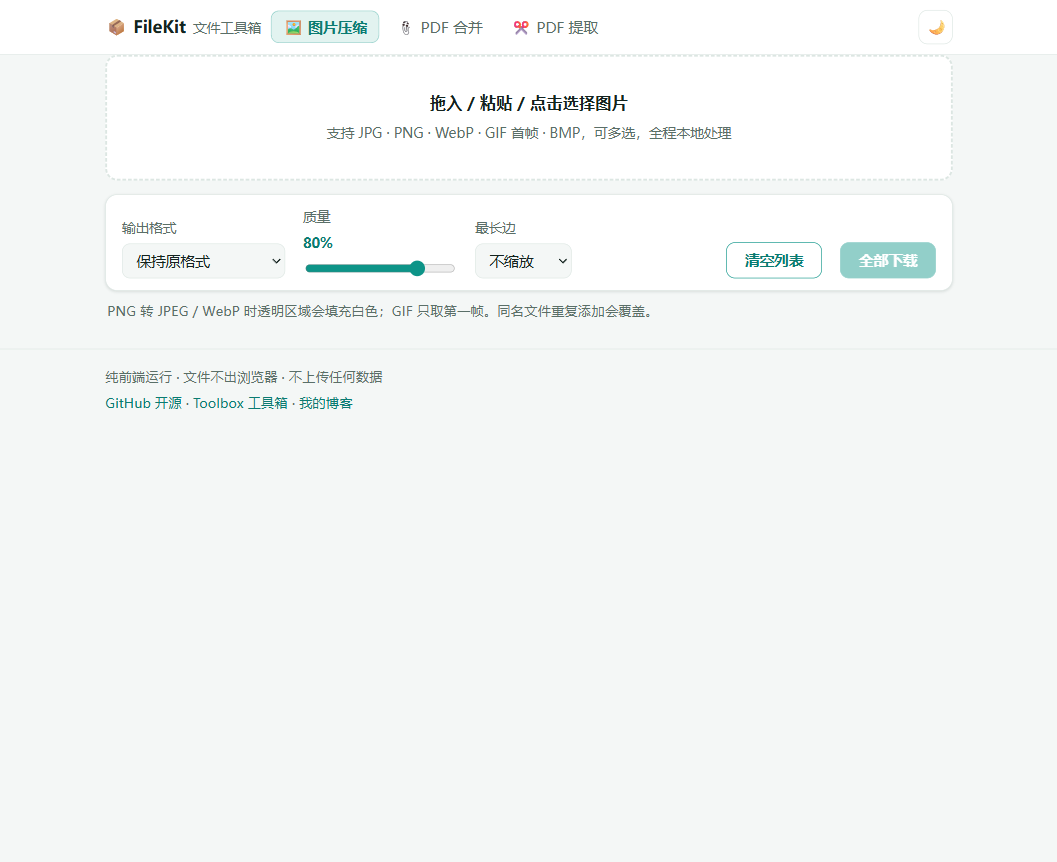
FileKit 是三个纯前端工具:图片压缩、PDF 合并、PDF 提取。没有账号,没有后端,页面运行时不发任何网络请求——文件从选中到下载,全程停在浏览器内存里。整个项目是 126 行 HTML、195 行 CSS、442 行 JavaScript,加上一个 525KB 的 pdf-lib。没有构建步骤,随便起个静态服务器就能跑。
三个工具,共用一套外壳
单页、三个标签页,切换时不刷新也不丢状态。这套外壳解决的都是小问题:拖拽和点击走同一个 bindDropzone,图片标签页额外支持 ⌘V 直接粘贴;标签用 role="tablist" 实现,左右方向键可以切换;深浅色跟随系统,手动切过就记进 localStorage。
不注册账号是有意的。文件工具的使用频率很低——你可能一个月才合并一次 PDF,为这个填邮箱、收验证码,体验不会比上传好到哪去。打开、处理、关掉,三步结束。
图片压缩:四行 Canvas 和三个坑
压缩的主链路很短:createImageBitmap 解码,按最长边算缩放比例,drawImage 到 canvas,toBlob 重新编码。真正花时间的是三个细节。
第一个是方向。手机拍的 JPEG 经常带着 EXIF 旋转信息,直接丢进 canvas 会横过来,所以解码时要传 imageOrientation: 'from-image',让浏览器先把方向摆正。
第二个是透明。canvas 默认透明,编码成 JPEG 时透明区域会变黑。代码里在画图前先铺一层白色,再画图片;PNG 转 JPEG 或 WebP 会丢透明通道,这条也直接写在界面提示里。
第三个是格式。选择「保持原格式」时,PNG 和 WebP 原样输出,其余一律转 JPEG——手机相册里最常见的是 HEIC 和 JPEG,前者浏览器解不了,后者本来就需要重新编码。质量滑块只对 JPEG 和 WebP 生效,PNG 是无损格式,toBlob 会忽略质量参数。
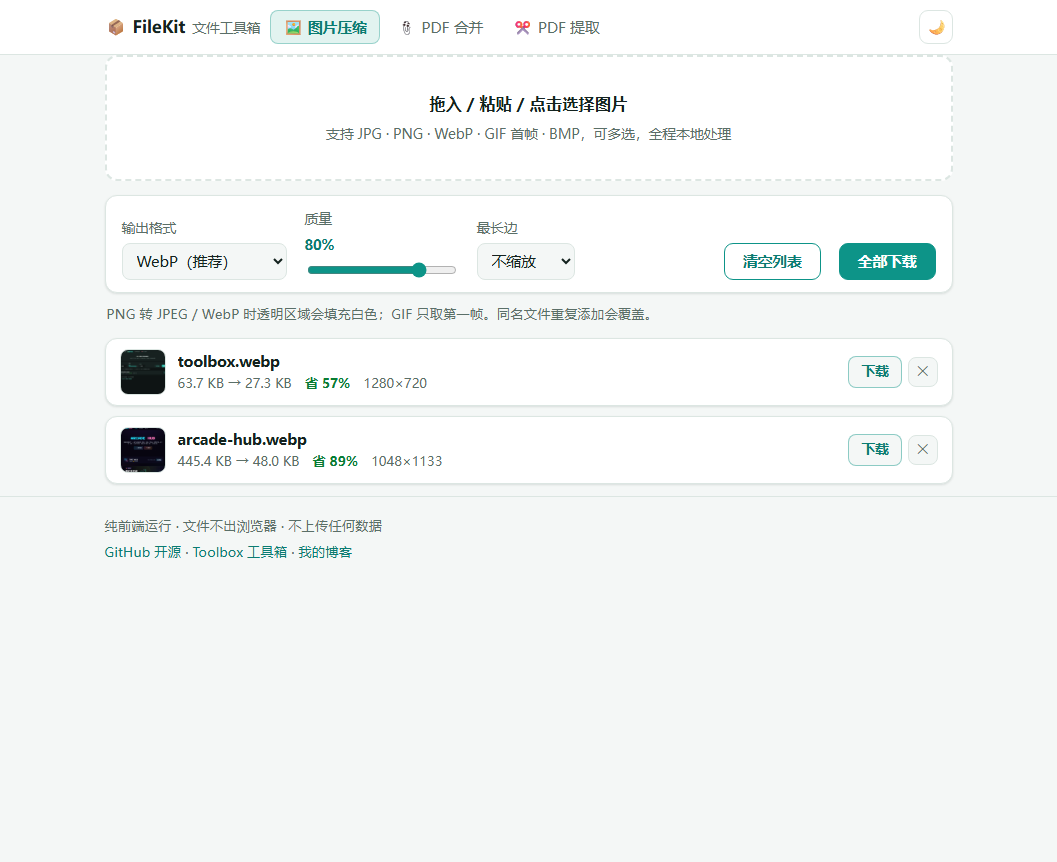
截图里的两张图,一张是 63.7 KB 的 JPEG 转 WebP,降到 27.3 KB;另一张是 445.4 KB 的 PNG 截图,降到 48.0 KB,省了 89%。PNG 截图色块多、重复度高,压缩空间本来就大。
反过来,把已经压过的 JPEG 再以 80% 质量压一遍,通常只省 0–1%,有时甚至更大。这种时候界面不会假装成功,而是显示「大 73%(原格式已足够小)」。文件工具的诚实比数字好看重要——用户要判断的是「这个结果值不值得用」,不是听一句「压缩完成」。
下载走 URL.createObjectURL(blob) 加一个临时的 <a download>,点击后延迟 4 秒再 revokeObjectURL,给浏览器留出读取时间。「全部下载」是逐个触发的,每两个之间停 350ms——浏览器对连续下载有限制,太快会被拦,这一点没法用纯前端绕过。
PDF:不渲染页面,只搬页面
合并和提取都不需要把 PDF 画出来,只需要操作页面树:把 A 文档的第 1–3 页复制到新文档,再接上 B 文档的全部页。pdf-lib 正好只做这件事,压缩后 525KB,直接放仓库里,不走 CDN,断网也能用。
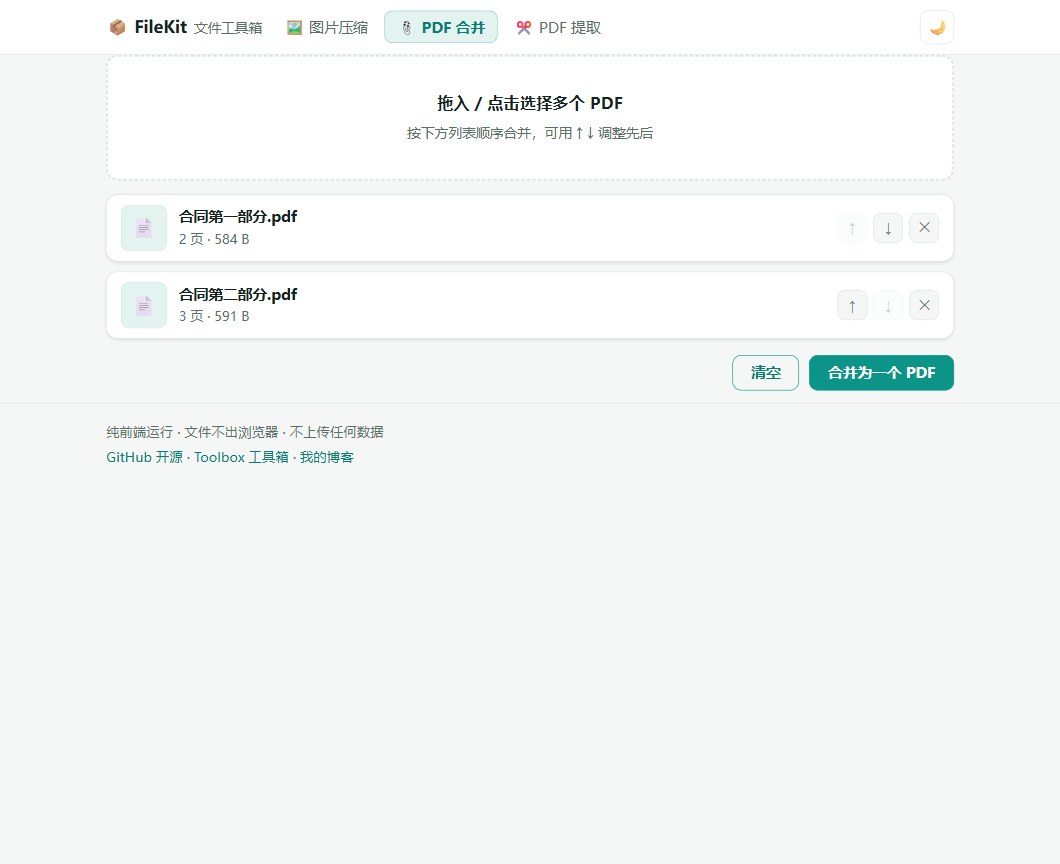
读取是 file.arrayBuffer() 拿到完整字节,PDFDocument.load(bytes, { ignoreEncryption: true }) 解析;合并时对每个源文档 copyPages,按列表顺序 addPage,最后 save() 出 Uint8Array,包成 Blob 下载。合并队列支持 ↑ ↓ 调序,少于两个文件时按钮保持禁用。
提取的输入是一个页码范围,比如 1-3, 5, 8-。解析器接受中英文逗号、顿号和省略结尾的区间,逐个校验不能越界;输出可以合并成一个 PDF,也可以每页拆成单独文件。留空就提取全部页。
没有用 pdf.js 的原因很简单:它擅长渲染和阅读,带 worker、字体和一堆兼容层;而这里只需要搬运页面,pdf-lib 的体积和能力刚好匹配。用不上的能力,加载它也是成本。
代价同样明确:整个文件要读进内存,几百 MB 的 PDF 在手机上可能直接卡死;ignoreEncryption 只是尽量读加密文档,遇到真正的权限保护仍会失败;输出不会重新压缩图片,合并后的体积基本等于各页之和。这些不是 bug,是「浏览器里做完」的边界。
零上传的三个代价
零上传换来的东西很实在:没有上传等待,没有服务器账单,没有「文件将在 24 小时后删除」的承诺需要相信。断网时它照样工作,这一点在高铁和会议室里很有用。
但它也有三个绕不开的代价。
格式支持由浏览器决定。 Chrome 能解 JPEG、PNG、WebP、GIF、BMP,解不了 HEIC;GIF 只能取第一帧。用户拖进一个 iPhone 原图,得到的是一句「浏览器不支持 HEIC,请先转换」,而不是一个假装成功的文件。
内存就是上限。 图片还好,PDF 是整份读入的。arrayBuffer() 之后,原文件、pdf-lib 的文档对象、输出字节会同时占内存,文件越大越明显。真要处理超大 PDF,得上流式解析或 Web Worker,那是另一个量级的工程。
批量操作要迁就浏览器。 没有服务器打包 ZIP,就只能连续触发下载;浏览器可能弹一次「是否允许下载多个文件」,用户拒绝后只能一个个点。这是纯前端的物理限制。
没有框架的边界
442 行 JavaScript 里,状态是三个数组:待压缩图片、待合并 PDF、提取结果。每次操作后调用对应的 render 重画列表,事件委托挂在列表容器上。没有路由,没有跨组件共享状态,没有需要响应式的异步流——这种规模上框架,收益抵不过多出来的一层抽象。
但如果继续长,边界很快就到:加撤销、加后台压缩、加 ZIP 打包、加拖拽排序的动画,手写 DOM 会开始变累。那时候该拆的拆,该上 Worker 的上 Worker,该引框架的引框架。工具的选择应该跟着问题走,而不是反过来。
FileKit 没有服务器,所以也没有服务器账单、上传队列和清理任务。三个工具各自只做一件事:把文件处理完,还给你。
本文由 AI 自动写作流水线生成;文中的压缩体积、比例与界面截图均为本机浏览器实际运行结果。