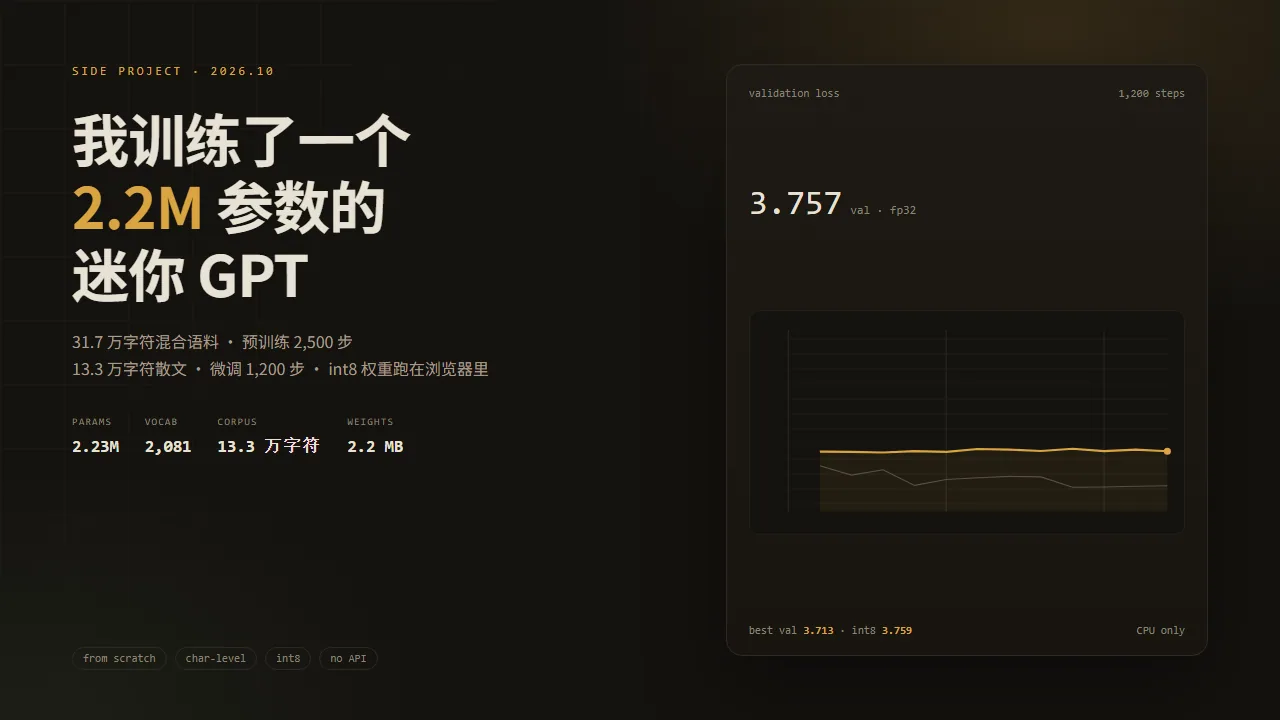
2.23M 参数、4 层、d192、ctx256;混合语料 2,500 步 best val 3.235,散文语料微调 1,200 步后在散文验证集上是 3.755;int8 量化后约 2.2MB,浏览器手写前向 + KV cache,本机 73–116 tok/s。第一版输出里全是代码残片,第二版靠语料清洗和采样层约束把它拉回中文:现版干净模式下续写 78.6% 是汉字,ASCII 标点 0.00%、4-gram 复读 0.0%。
这个项目的起点不是「我要做一个 ChatGPT」,而是一个更小的问题:一个语言模型的最小闭环,到底由哪些零件组成?
我把问题拆成四件事:语料、tokenizer、Transformer、训练循环。四件都在这个项目里完成,不下载预训练权重,不调任何 API。最后再加一件:把权重搬到浏览器里,让读者打开网页就能看到它写字。
模型很小,2.23M 参数;语料也不大,316,810 个字符。它写不出完整文章,但它把「文本 → 训练 → 权重 → 推理」这条链路完整走了一遍。这篇文章记录的就是这条链路。
第一版训练完之后,它确实学会了 Markdown 和代码块的节奏——续写里全是反引号、花括号和表格残片,能看,但基本没法读。于是有了第二次训练:先把语料洗干净,再在干净语料上微调 1,200 步。
语料:把这个博客自己喂给模型
我没有去网上找通用语料,因为那样模型学到的是别人的文风,和这个博客没有关系。语料是从本地项目里现抽的,extract.mjs 做三件事:
- 扫
data/blog下全部文章,去掉 frontmatter、JSX 标签和代码围栏标记; - 收 cha-lang 的 README、系列大纲和示例程序;
- 收
C:/works下各项目的 README。
最后得到 75 篇文档、316,810 个字符、2,081 个不同字符。中文占 27.2%,剩下的主要是英文、代码和 Markdown 符号。出现频率最高的字符是空格,然后是 e、换行、t、o——这个分布已经很诚实地说明了语料的构成:它不是一个纯中文语料,而是一个「博客 + 代码仓库」的混合体。
这带来一个后面会反复出现的副作用:模型会把 Markdown 的星号、代码块的反引号、JSON 的花括号一起学进去。它写出来的东西经常像「博客和代码的混血」,这是语料决定的,不是模型突然有了个性。
返工:把代码从语料里洗掉
第一版生成的样本里,代码块、表格分隔线、URL 残片占了很大比例。统计了一下原始语料:围栏代码块 30.8%、URL 9.7%、表格 6.9%、图片语法 5.7%,真正的散文不到一半。2.2M 参数的容量,有相当一部分花在了学 Markdown 语法上。
于是写了第二个抽取脚本 extract_prose.mjs:
- 去掉 frontmatter、围栏代码块、表格、图片、URL、JSX,以及博客模板尾部(
Back to posts、目录、Edit on GitHub); - 保留行内代码的文本,只去掉反引号——否则「结构有
BrowserRouter和HashRouter两种模式」会变成「结构有 和 两种模式」这种缺词的句子; - 丢掉纯英文代码行,但含中文的行一律保留,避免把代码注释里的中文说明误杀。
清洗后得到 72 篇文档、133,072 个字符,中文占 54.1%,代码块为零。微调沿用第一阶段的 2,081 字符表,其中有 44 个新字符(后来文章里的 emoji)不在表里,直接跳过。语料小了一半多,但每个字符更像「人话」。
字符级 tokenizer:2,081 个 token 的极简方案
我没有训练 BPE,也没有用现成的 tokenizer。做法简单到只有三行:
corpus = open('corpus.txt', encoding='utf-8').read()
chars = sorted(set(corpus))
stoi = {c: i for i, c in enumerate(chars)}
每个字符就是一个 token。中文不需要分词,「字节码」是 3 个 token;代码里的 {、}、* 也各自是一个 token。这样做的好处是没有 tokenizer 的训练和对齐问题,所有字符一视同仁;坏处是同样一段话占的 token 更多,每个 token 承载的语义也更少。
对 2M 参数的小模型来说,这个取舍是合适的:它把「分词」这个变量彻底消掉了,模型学不好就只能是模型本身的问题,不会甩锅给 tokenizer。
模型:2.23M 参数,够小才跑得动
架构是标准的 decoder-only Transformer,配置如下:
| 项目 | 值 |
|---|---|
| 层数 | 4 |
| 注意力头 | 4 |
| 隐藏维度 | 192 |
| 上下文 | 256 个字符 |
| 词表 | 2,081 |
| 参数量 | 2,228,544 |
| 权重绑定 | 输入 embedding 与输出 head 共享 |
| Dropout | 0.15 |
每个 block 是 Pre-LN 的因果自注意力 + GELU MLP:
mask = torch.triu(torch.ones(T, T, dtype=torch.bool), 1)
h = self.ln1(x)
a, _ = self.attn(h, h, h, attn_mask=mask, need_weights=False)
x = x + a
x = x + self.mlp(self.ln2(x))
输入 embedding 和输出 head 共享同一份权重,这是从 nanoGPT 学来的做法:既省参数,也让输入和输出在同一个向量空间里。2,228,544 个参数,用 int8 存大约 2.2MB——比一张手机照片还小。
训练:CPU 上的 2,500 步
机器没有独立 GPU,全程 CPU 训练(PyTorch 2.14.1+cpu,24 线程)。超参也很朴素:
- batch 16,上下文 256,每步 4,096 个 token;
- AdamW,学习率 3e-3,100 步 warmup 后余弦衰减;
- dropout 0.15,梯度裁剪 1.0;
- 训练 2,500 步,大约 1,024 万个 token,相当于在 30 万字符的训练集上过 34 遍左右。
每 100 步在验证集上算一次 loss,只有验证 loss 创新低时才保存 ckpt.pt。最后 best val 是 3.235(发生在第 2,500 步),最终 train loss 约 2.224,训练循环耗时 37.0 分钟。
作为参照:词表是 2,081,随机猜的交叉熵是 ln(2081) ≈ 7.64。best val 3.235 意味着模型对下一个字符已经有了一定的把握,但离「会写文章」还很远。
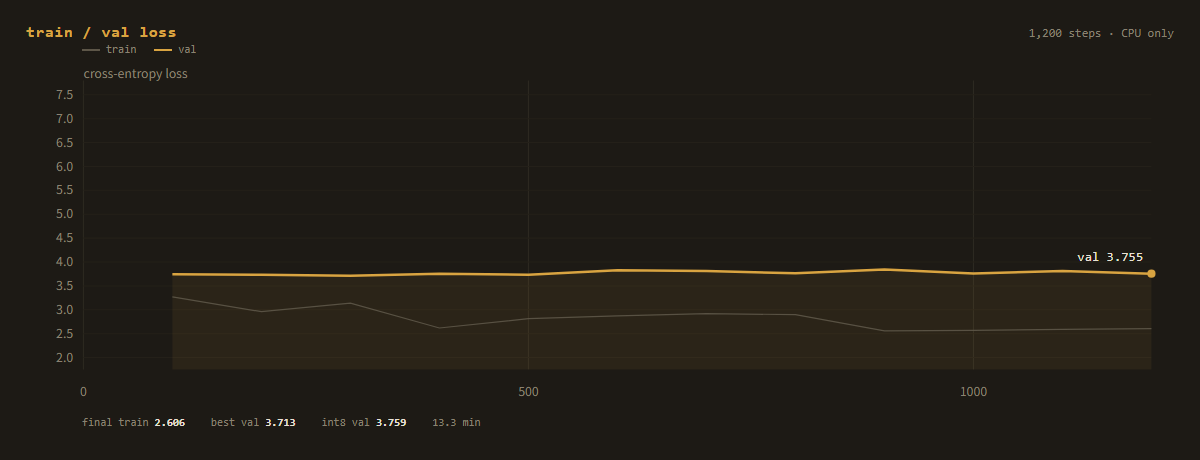
灰线是训练 loss,金线是验证 loss。验证 loss 在 3.235–3.387 之间震荡下行,到第 2,500 步才创下最低值;曲线没有明显回升,过拟合的迹象很弱,更多是 2M 参数与 31 万字符的容量上限。
把验证点摊开看:
| step | val |
|---|---|
| 100 | 6.366 |
| 200 | 5.205 |
| 300 | 4.509 |
| 400 | 4.257 |
| 500 | 4.023 |
| 600 | 3.992 |
| 700 | 3.932 |
| 800 | 3.890 |
| 900 | 3.719 |
| 1,000 | 3.679 |
| 1,100 | 3.601 |
| 1,200 | 3.554 |
| 1,300 | 3.460 |
| 1,400 | 3.449 |
| 1,500 | 3.429 |
| 1,600 | 3.385 |
| 1,700 | 3.377 |
| 1,800 | 3.339 |
| 1,900 | 3.361 |
| 2,000 | 3.387 |
| 2,100 | 3.351 |
| 2,200 | 3.297 |
| 2,300 | 3.274 |
| 2,400 | 3.294 |
| 2,500 | 3.235 |
曲线和大多数从零训练的小模型一样:前 500 步降得很快,1,800 步后进入 3.2–3.4 的平台区,最后靠学习率衰减又挤出一点。到 2,500 步时,训练 loss 还在降,验证 loss 已经基本走平——2M 参数的容量和 31 万字符的语料,差不多到头了。
第二阶段:在散文语料上微调 1,200 步
先说一个试错:我最初在清洗后的散文语料上从零训了 3,000 步,验证集却停在 4.22,比第一版模型在同一份散文验证集上的 3.80 还差。133K 字符对 2.2M 参数来说太少了,语料变干净,但信息量也少了一半多。于是改成微调:以第一阶段的 ckpt 为初始化,沿用 2,081 词表,只换数据。
超参也相应收小:学习率 5e-4,warmup 50 步,余弦衰减,batch 16,dropout 0.1,训练 1,200 步。散文验证集上的 loss:
| step | val |
|---|---|
| 200 | 3.734 |
| 400 | 3.757 |
| 600 | 3.829 |
| 800 | 3.765 |
| 1,000 | 3.760 |
| 1,200 | 3.755 |
最低点是第 300 步的 3.713,之后略有回升——1,200 步时训练 loss 已经降到 2.6,验证 loss 却下不去,是教科书式的过拟合。这里的 3.713 和第一阶段的 3.235 不能直接比:验证集换了,散文这份更难预测。
但上线用的是第 1,200 步的权重,不是最低点那份。理由是可读性指标:同一份评测脚本、同一组固定种子,1,200 步版本的输出中文占比更高、代码符号更少(后文「采样层」一节的消融表第 2、3 行)。两份权重的验证 loss 只差 0.04,而 demo 是给人看的,我按输出选。这个决定不算对——如果有人要拿权重继续训练,应该拿 3.713 那份。
它到底学会了什么
训练日志每 500 步会打三段续写。下面三段是第一版权重(混合语料 2,500 步)用旧默认参数 temperature=0.85、top-k=40 生成的,原样贴出——先看看「没法读」长什么样:
『我用 AI』
我用 AI 的小绪数据就可以继续的 API 的数据。

```
 const uction = 1) {
 sthis.e // = 1; // ever(video = x 1);
 int(
 if (var {
 // 返回调
 eturn esole.log(n, state);
『这个项目的核心是』
这个项目的核心是客户端的 JSON/JECRS 的工具的 `ariptable` 请求的方式,通过程序和 RON.md` 是请求的参加载时间的请求。

## [](#1-添加必要环境变量

| ---------------------------------------------------
『字节码』
字节码(一) | **部署)、 | 20400×9ms |
| 256 万次 |
| ×6 | Vercel 202 个人脸溢出入 | Nept.0ms |
| 1.0 |
| **1.16 | 25 | **2.9 | | 2258100ms |
| **1 种常见 | + 114.
同一组采样参数(seed 1、temperature 0.85、top-k 40、每段 140 字),来自第一版的 int8 权重。
这些样例说明了两件事。
第一,它确实学到了局部文风和格式:开头的语气、Markdown 的骨架、代码块的节奏,甚至我写文章时爱用的连接词,都能在输出里看到影子。
第二,它没有学到事实和推理。句子之间没有真正的因果关系,更多是「上一个字符之后最像下一个字符的是什么」。它会把星号、反引号、花括号当成一种高频搭配吐出来,因为语料里这些东西太多了。
第 500 步时的样例还基本是乱码;到第 2,500 步,已经能写出局部通顺的短句和完整的 Markdown 结构,但整段仍然经常跑题、重复,甚至退化成表格和代码碎片。这个进步是真实的,但距离「可用」还有很长的路——这也是 2M 参数模型应有的样子。
int8:把模型压到 2.2MB
训练完的 ckpt.pt 是 fp32,约 8.9MB。导出时我对每个二维权重矩阵做了按行对称量化:
amax = np.abs(w).max(axis=1)
scale = np.where(amax > 0, amax / 127, 1.0).astype(np.float32)
q = np.rint(w / scale[:, None]).clip(-127, 127).astype(np.int8)
每个输出行有自己的 scale,w ≈ q * scale。LayerNorm 的权重、bias 这些一维小张量保留 fp32,因为它们占比很小,量化收益不大。最终 int8 权重 2,218,176 字节,加上元数据和 scale,整个二进制约 2.2MB。
量化对精度的影响(散文验证集):
| 版本 | 验证 loss |
|---|---|
| fp32 | 3.7568 |
| int8 | 3.7593 |
(训练日志里的 best val 用随机窗口估计;这里的 fp32 / int8 是导出脚本在固定的 24 个验证窗口上复测的,绝对值不能逐位对比。)
差了 0.0025。对这样一个本来就不追求精度的模型来说,这个代价可以忽略。int8 只是省空间和带宽,它不会让模型变聪明。
浏览器里手写一次前向
页面没有用 ONNX Runtime,也没有用 WebGPU:2.2M 参数太小了,手写循环足够快,还能少一个依赖。
核心是一个 int8 点积:
for (let o = 0; o < rows; o++) {
  let s = 0
  for (let i = 0; i < cols; i++) s += q[o * cols + i] * x[i]
  out[o] = s * scale[o] + bias[o]
}
生成时用了 KV cache:每个新字符只算自己的 q/k/v,然后和缓存里的历史 k/v 做注意力,而不是把整个前缀重新跑一遍。否则生成 160 个字符的计算量会翻几十倍。
const cacheBase = (layer * nHeads + head) * block * headDim
kCache[cacheBase + pos * headDim + d] = k[d]
实现完之后我做了两次数值对齐:同一段 prompt,PyTorch 和 JS 的最后一位 logits 最大误差 1e-5;用贪心解码连续走 24 步,24/24 个 token 一致。这个误差来自浮点累加顺序和 GELU 的 erf 近似,已经足够小。
页面跑在 Web Worker 里,权重通过 fetch 流式加载,生成时逐字 postMessage 回主线程,所以主线程不会卡。这台机器上的 Chromium 实测:空闲时约 110 tok/s(160 字 1.4 秒),机器上同时跑着别的东西时会掉到 73 tok/s(160 字 2.2 秒)——同一个页面、同一份权重,差距全在 CPU 争用上。手机和低功耗设备会慢一些。
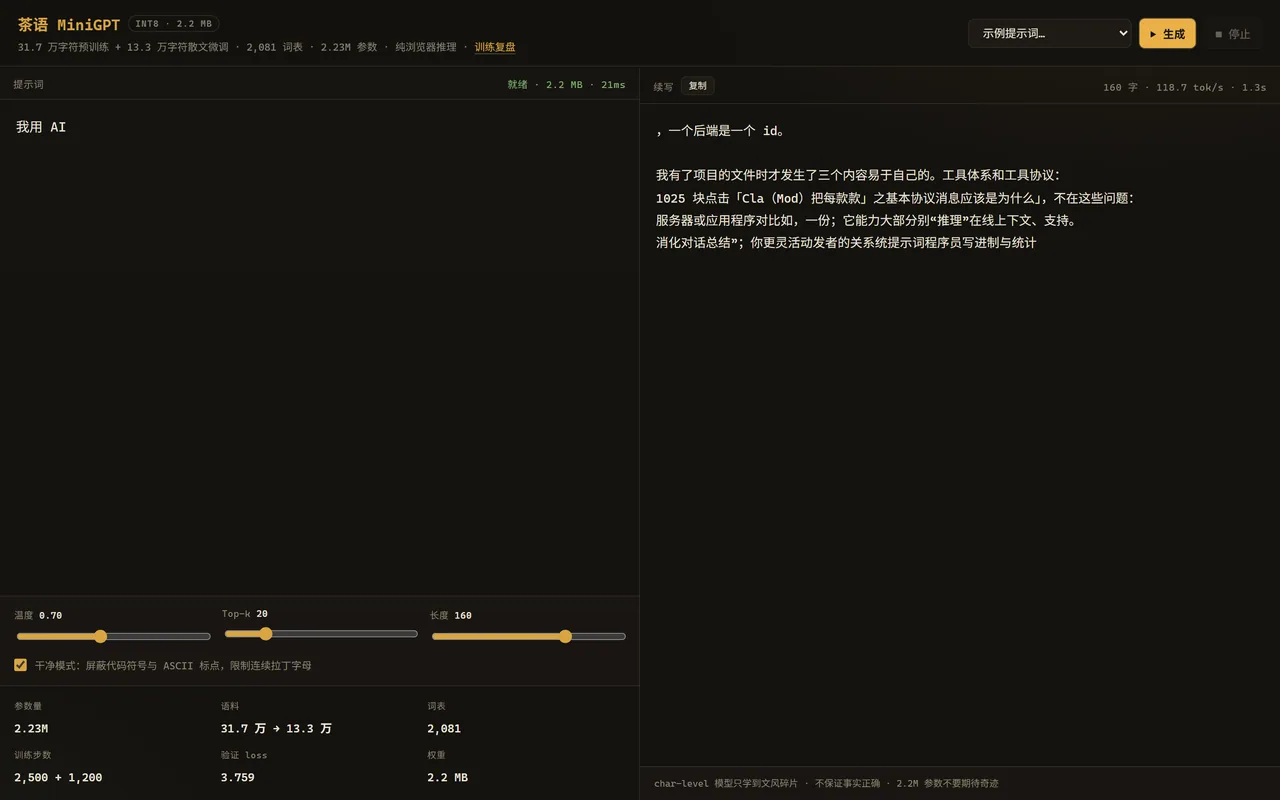
页面截图:左边是提示词和采样参数,右边是流式输出。所有权重都在浏览器里,没有服务端推理。
在线试玩:茶语 MiniGPT →(首次打开需要下载约 2.2MB 权重)
采样层:把乱码挡在输出之前
换权重只解决了一半问题。另一半在 sample() 里——第一版页面只有最朴素的 top-k 采样,小模型的所有坏毛病都被原样放大。这一轮改了四处:
1. 修了一个 tokenizer 的 bug。 提示词里遇到词表外的字符(emoji、生僻字)时,旧代码用 stoi.get(c) ?? 0 兜底,而 id 0 恰好是换行符。也就是说,你输入一个 emoji,模型就在提示词里凭空看到几个换行,后面的分布整个跑偏。现在词表外字符直接丢掉:
encode(text) {
  const ids = [];
  for (const c of text) {
    const id = this.stoi.get(c);
    if (id !== undefined) ids.push(id);
  }
  return ids;
}
2. 重复惩罚。 最近 96 个 token 的 logit 除以 1.15(负的乘 1.15,保持符号),这是最常见的做法,压掉「慢慢慢慢」这种原地打转。
3. 禁止复读 n-gram。 比重复惩罚更狠:如果当前结尾的 3 个字符在历史上出现过,就把当时紧跟其后的那个 token 的 logit 设成 -Infinity。它防的是「整句整句地抄自己」——惩罚只是削弱,这个是直接封杀。
4. 干净模式。 页面默认勾选的一栏,做两件事:把一批符号的 logit 置 -Infinity;连续拉丁字母到 3 个就禁掉字母表,逼它别再用 tionrexl 假装英文。
这一条上线后又返了一次工。第一版只禁了 21 个 Markdown / 代码符号,我在真实浏览器里复验时看到输出长这样:ref 的 inp-sta、代码、3.2 out()、map:Cl+cal。括号、点号、加号、连字符、半角冒号全都漏了。中文散文用的是全角标点(,。:;?!()),ASCII 标点小模型吐出来基本只会是代码残片,所以第二版把它们一并禁掉,只留汉字、字母、数字、空格和换行:
// v1:21 个 Markdown / 代码符号
const BAN_V1 = '#*_`{}[]<>|\\=;~^$@"\'/'
// v2:补上 ASCII 标点,中文散文不需要它们
const BAN_CHARS = BAN_V1 + '.,:!?()+-&%'

function applyCleanMask(logits, history) {
  for (const id of banIds) logits[id] = -Infinity
  if (history.length >= 3) {
    const tail = history
      .slice(-3)
      .map((id) => model.decode(id))
      .join('')
    if (/^[A-Za-z]{3}$/.test(tail)) for (const id of letterIds) logits[id] = -Infinity
  }
}
四条都加完,默认参数从 0.85 / top-40 收到 0.7 / top-20。用同一份脚本、同样 5 个提示词、每段 160 个字符、固定种子跑一遍消融,把「权重」和「采样层」两个变量分开看:
| 权重 | 采样 | 中文 | 拉丁字母 | ASCII 标点/符号 | 4-gram 复读 | 最长拉丁串 |
|---|---|---|---|---|---|---|
| 第一版(混合语料 2,500 步) | 旧默认 0.85 / top-40 | 16.5% | 44.8% | 21.75% | 13.6% | 9 |
| 微调 300 步 | 旧默认 0.85 / top-40 | 31.4% | 33.8% | 11.75% | 4.6% | 14 |
| 微调 1,200 步 | 旧默认 0.85 / top-40 | 36.8% | 35.8% | 3.50% | 7.5% | 11 |
| 第一版(混合语料 2,500 步) | 0.7 / top-20 + 干净模式 v1 | 67.9% | 12.0% | 4.38% | 0.0% | 0 |
| 微调 300 步 | 0.7 / top-20 + 干净模式 v1 | 62.7% | 9.4% | 6.38% | 0.0% | 0 |
| 微调 1,200 步 | 0.7 / top-20 + 干净模式 v1 | 65.7% | 9.6% | 3.37% | 0.0% | 0 |
| 微调 300 步 | 0.7 / top-20 + 干净模式 v2 | 77.8% | 5.3% | 0.00% | 0.0% | 0 |
| 微调 1,200 步(现版) | 0.7 / top-20 + 干净模式 v2 | 78.6% | 2.4% | 0.00% | 0.0% | 0 |
先说口径:这张表的「ASCII 标点/符号」统计的是全部 ASCII 标点,比我最初发出去的版本宽。第一版只数了 Markdown 与代码里常见的那批符号(反引号、花括号、尖括号、方括号、竖线、井号、星号、下划线、斜杠、等号、分号、美元符),漏掉了点号和半角括号,于是 v1 那三行显示 0.00%,看着像已经干净了——其实没有。同一批样本换成正确的口径重算,v1 还剩 3.37%~6.38%。
换第二组种子(seed 23、每段 120 字)再跑一遍,结论一致:现版干净模式下微调 1,200 步中文占比 73.2%、微调 300 步 64.1%,ASCII 标点仍是 0.00%。
三条读数:
- 语料清洗有效:不换采样,只换权重,ASCII 标点从 21.75% 掉到 3.50%,中文占比 16.5% → 36.8%;
- 采样层更立竿见影:第一版权重加上四条约束,中文占比 16.5% → 67.9%。也就是说,之前那屏「乱码」里,相当一部分不是模型笨,是我把最差的采样参数和一份充满 Markdown 的语料叠在了一起;
- 遮罩的范围决定上限:把禁的符号从 21 个扩到 32 个(模型词表里这 32 个都在),微调权重的中文占比 65.7% → 78.6%,拉丁字母 9.6% → 2.4%,ASCII 标点 3.37% → 0.00%。同一份权重、同一组种子,只是多禁了 11 个字符。
上线配置下的三段续写(seed 7、0.7 / top-20、干净模式 v2,原样贴出):
『我用 AI』
 的去解决了。

如果你尝试过很多,我让它为了一个小时间线图纸完整,这段办法:

103040、心斋桥梁。在什么时候要开始改成长什么样式披露前端开发的东西不太离;可分千年有人在自己算是一个方案比较慢得纪认卡 24 天花真实,但那种症状。
总结语计划后续发票和老家银行(HK】Ant)、八坂神治地、公交、完税务局部分散?、
『字节码』
:用 VM 的方法例:

2、测试探法不得了全局部变量「解析器」——这个数组,而是全局环境里有个项目里,它们可以在一份坑也能用户自己少「错误。这段被看下降级。
本系列代码在第二章会被控制是最后的解释器里变成 1 章:

语义:同一个字节码全局部语句应用的 fib。但是「解析完整地方式表达式回溯」,但是第二遍:把每行了—
『写代码最』
难的。
2025 年,不是这一个博客是我自己定义了三段文章带来。
第二天一次没有去年度计划到了很多,但让我们当然就会报错、工作、公里的事情绪价格也能力被控度的小时抓住院。

10 万达式却异常再回来跑步在急诊台上面后立刻意思量,真正出来说得它就像是我的人一个。
80~35 月 24年底几乎没给自己有都“工具”,而这样”
比起第一版,这些已经是「像中文的东西」:有标点、有分句、有段落,甚至能围绕提示词的主题打转(『字节码』那段全在说解析器和作用域),而且再没有一个 ASCII 标点。但别误会——句子之间依然没有逻辑,VM、fib、HK】Ant 这种三字母碎片还是会冒出来,因为词表里有 100 多个拉丁字母 token,模型学到过它们在散文里出现。
必须说清楚:干净模式是遮罩,不是治病。 它没有让模型学会「不写代码」,只是在采样时不许它写。我在真实浏览器里做了个 A/B:其余参数一个不动,只把勾选框取消,两段生成里立刻冒出 5.63% 的 ASCII 标点和 7 段四个字母以上的拉丁串,中文占比从 72.7%(五段平均)掉到 54.4%。真正让输出变干净的是那 13.3 万字符的散文语料,采样层只负责把剩下的坏尾巴压住——以及,度量口径写窄一点,你就会以为尾巴已经压完了。
它不会做什么
必须把话说清楚:这是一个教学模型,不是产品。
- 它不会回答问题,也没有指令微调。你给它「帮我写个周报」,它只会顺着字符概率往下编;
- 上下文只有 256 个字符,写不了长文;
- 第一版语料里中文只占 27.2%,其余大量是代码和 Markdown;微调语料中文提到 54.1%,但只有 13.3 万字符,覆盖面很窄;
- 它可能复述训练语料里的句子。2M 参数记不住整篇文章,但记住局部片段是可能的;
- 散文验证集上 3.755 的 loss 仍然不低(随机猜是 ln(2081) ≈ 7.64),错误是常态;
- 关掉干净模式,输出立刻退回代码残片和 Markdown 骨架。
如果你需要一个能完成任务的模型,去用 API;如果你想亲眼看看 LLM 内部的矩阵乘、注意力和采样长什么样,这个 demo 的前向代码全部在浏览器里,可以直接读。
交付物
extract.mjs/extract_prose.mjs:两版语料抽取,第二版把围栏代码、表格、URL、模板页脚洗掉;train.py:字符级 GPT,4 层 / d192 / ctx256,纯 CPU 训练,支持从已有 ckpt 续训(CHA_INIT/CHA_CORPUS/CHA_STEPS);export_int8.py:按行量化 +model.bin/model.json导出,并在固定验证窗口上复测 fp32 / int8 loss;engine.js:浏览器前向,含 KV cache、int8 反量化、GELU、top-k 采样、重复惩罚、no-repeat n-gram 与干净模式遮罩;worker.js/app.js/index.html:流式生成页面,风格对齐 cha-playground;eval_matrix.mjs:固定种子的可读性消融,输出中文占比 / 拉丁字母 / 代码符号 / 复读率四列;- 在线页面:茶语 MiniGPT。
留几个小练习:
- 把
N_LAYER从 4 加到 6,参数量翻倍,验证 loss 会降多少? - 把干净模式的符号黑名单单独关掉,只留重复惩罚和 no-repeat,看四条约束里哪一条贡献最大——
eval_matrix.mjs里改一行配置就行; - 把 char-level 换成 BPE,词表扩到 8,000,比较同样的训练步数下的验证 loss;
- 给页面加一个
temperature=0的贪心模式,观察它是不是更容易陷入循环; - 把 int8 点积换成 WebGPU,测一下在这台机器上能快多少。
最后
这是我从零走完的第一条 LLM 链路:没有预训练权重,没有 API,没有 GPU。它很小,小到可以塞进一个静态网页;也足够完整,完整到能解释每一步在做什么。
第一版跑通之后,它的输出基本没法读。这一轮返工让我印象最深的两件事,都不在模型结构里:一件是语料里有 30.8% 是围栏代码块,模型老老实实地照学了;另一件是采样层三条约束带来的提升,比多训 900 步大得多。在小模型上,数据清洗和解码策略的收益远大于堆参数。
模型还是写不出好文章,但这次至少证明了:那些看起来很神秘的矩阵,真的可以一行一行写出来。
本文由 AI 自动写作流水线生成;文中的语料统计、训练曲线、续写样例、量化误差与浏览器性能均为本机实际运行结果。