零 npm 运行时依赖手写 RFC 1951/1952,node:zlib 只出现在 tests/ 当裁判。位流读向统一为 LSB-first 消费:解码端建表时位反转一次(table[idx] = len | (sym << 4),解码一符号 = 掩码+查表+移位,零树行走),编码端用预反转数组;peekBits 允许虚拟补 0、consumeBits 按真实计数裁决。inflate 覆盖 stored/fixed/dynamic 三块型与 code length 元字母表 16/17/18,Kraft 校验逐条对齐 zlib inftrees.c(含单距离码 1 位特例,codelen 表连特例都不给),热循环状态局部化把 inflate 从 22.5 提到 31+ MB/s(输出口径 48-53)。deflate 用 hash chain 懒匹配 LZ77(nice/max_lazy/max_insert_length 三道闸门全对齐 zlib),stored/fixed/dynamic 精确计位三选一,限长码用频率减半重试(收敛到全 1 时深度 ≤9,必然终止),CRC-32 slicing-by-4 达 506 MB/s。差分压测 10,458 条语料(0B-10MB,种子固定)×5 方向逐字节相等;2,500 条坏流无一死循环,结局与 node 逐条一致,进度单调是结构保证。抓虫实录三条:LEN_SYM 声明成 Uint8Array 把符号 270 静默截断成 14(产物流合法,node 解出只剩 12 字节);写入端 alignByte 照读取端语义镜像成"丢弃悬空位",而写入端该是补零提交;基准里四份 8MB 数据集共存让 GC 把 deflate 读数压低 2-3 倍。16 文件 187 用例全绿,inflate ≥48.5 MB/s、deflate lv6 ≥6.0 MB/s(验收线 30/5),压缩率与 node 同档 ±1-5% 打平,Web UI 单文件 21.7KB 已部署 https://deflate-lab.pages.dev。
编码器跑通的那个瞬间,node 的 inflate 吃下我发射的第一条流,一声不吭地解出了"原文"——只剩前 12 个字节。没有崩溃,没有警告,一条完全合法的 DEFLATE 流,安静地弄丢了数据。压缩格式最阴险的错误形状,在项目开工当天就现了形:它长得像成功。
那条流背后是一整套从零手写的编解码器:bit reader、三种块型、规范 Huffman、懒匹配 LZ77、CRC-32 查表、gzip 容器。运行时零 npm 依赖,node:zlib 只出现在 tests/ 里当裁判。这篇记它的骨架、三条抓虫实录,以及差分压测怎么把"大概对"逼成"逐字节相等"。
一份 1996 年冻结的位流
RFC 1951(DEFLATE)与 RFC 1952(gzip 容器)都在 1996 年 5 月定稿,此后三十年没改过一行。三十年里软件栈换了多少轮,.gz 一直没换:HTTP 的 content-encoding、npm 的 tarball、tar.gz 归档、PNG 的图像数据,底下全是这份位流。规格越老越值钱——它不会半夜改需求。
这是"零维护项目群"的又一个成员,选题标准与前几站相同:规格永冻结,完工即封存。裁判比模拟器那几站还省事,node:zlib 内置、C 写的、二十多年生产实现,一行 import 就是 oracle。任务书锁死的东西不多:公开 API 四个函数(inflate / gzip / gunzip / crc32)、TypeScript strict 加零 npm 运行时依赖、test 与 typecheck 全绿、差分压测 ≥10,000 条语料——最后一项在任务书里的原话是"本项目的灵魂"。
不同于模拟器三部曲的多会话并行,这是单会话工程,没有契约冻结、没有集成日。对手不是协作时序,是位流本身。
位与端序:一份累加器,两种读向
DEFLATE 位流的第一个陷阱写在 RFC 1951 §3.1.1:字节内所有字段按 LSB-first 进入流,唯独 Huffman 码字按 MSB-first 打包。同一个 bit reader,两种读向,这是 DEFLATE 全部端序复杂性的根源。
本实现不养两个 reader,读向统一为"LSB-first 消费",两个方向的差异各付一次性代价:
- 解码端:全展开查表,
table[idx] = len | (sym << 4)。表下标是"后续 N 个流位按 LSB-first 累积的整数",而 MSB-first 的码字在这个下标空间里恰好位反转——建表时反转一次,热循环零反转。解码一个符号等于 1 次掩码加 1 次查表加 1 次移位,没有任何逐位走树。 - 编码端:
writeCode先 reverseBits 再 writeBits;热路径(每个 token)走预反转数组,头部低频码才逐个反转。
流尾还有个容易漏的细节:peekBits 允许"虚拟 0 填充"(不足 N 位补 0 查表),但虚拟位不许蒙混过关——consumeBits 按真实计数裁决,不足即抛"位流意外结束"。宽容与严格分属两个函数,谁也不越界。
inflate:关于码长的码长
解码端覆盖三种块类型:stored(LEN/NLEN 反码校验的裸拷贝)、fixed(RFC 硬编码的码长表)、dynamic(码长表随流自带)。dynamic 的表头是 DEFLATE 最绕的一处——码长本身也要压缩:HLIT+257 个字面量/长度码长加上 HDIST+1 个距离码长,先经一张只有 19 个符号的 code length 字母表编码,其中 16/17/18 是三个"关于码长的码长":16 重复前一个符号 3-6 次、17 输出 3-10 个零、18 输出 11-138 个零。解码器先用元表解出两张正式表,再用正式表解数据,嵌套两层;任何一层越界(16 缺前值、17/18 重复越界)都必须是抛错,不能读飞。
Huffman 解码不走树。码长序列经 canonical 规则分配码字,全展开成查表;命中数据后,长度符号 257-285 与距离符号 0-29 各带扩展位,基值与扩展位直查表(长度/距离的 3/258、1/32768 这些端点全在里面)。表建成前过 Kraft 校验,判定逐条对齐 zlib inftrees.c:
- 超订(over-subscribed)一律非法;
- 不完整(incomplete)非法——除非恰好一个长度为 1 的码,这是 RFC 允许的单距离码特例:整份流只有一个距离码时,允许用 1 位编码。zlib 接受,我们也接受;
- codelen 元表连这个特例都不给,与 zlib 一致;
- 全零空表放行,非法性推迟到解码命中时才报,zlib 同款行为。
热循环把 BitReader 与输出缓冲的全部状态提升为局部变量,refill/peek/consume/回拷全内联,每符号省 4 次方法调用:inflate 从 22.5 提到 31+ MB/s(压缩输入口径),48-53 MB/s(输出口径)。类型系统为这个优化开了个小口——BitReader 的字段对 inflate 模块开放,源码注释写明"仅 inflateBlock 可触碰"。
deflate:懒匹配、三道闸门、计位三选一
编码端骨架是 LZ77:32KB 窗口、3 字节最小匹配、258 最大长度,hash chain 索引——3 字节折叠哈希 (b0<<10)^(b1<<5)^b2,zlib 同款,配 UPDATE_HASH 式滚动更新(每位置 1 次字节读代替 3 读 2 位移)。懒匹配的含义:当前位置找到匹配后不立即发射,先看下一位置能否更长,能就放弃当前的。链上搜索不是无底洞,搜索强度按 9 档配置(chain/nice/good/lazy 四参数),三道防坍塌闸门全部对齐 zlib 同名机制:
- nice:匹配够长立即停链;中选者出链后单独补齐到 258——长匹配不丢,长扩展只付一次;
- max_lazy:达到该长度立即发射、跳过懒探测——懒探测会让匹配位置的搜索开销翻倍;
- max_insert_length:超长匹配只补插尾部两个位置,内部位置不逐个入链。
good 命中后链预算 >>= 2、scan_end 双字节快拒、TokenBuf 按输入规模预分配(消灭倍增拷贝的 GC 垃圾),都在。
块类型决策做精确计位三选一:stored、fixed、dynamic 各算总位数——动态块要连 HLIT/HDIST/HCLEN 与 RLE 流的开销一起算——选最少者发射。成本估算与发射共用同一份 planDynamicHeader 结果,永不脱节。动态码长超限(≤15)不用 package-merge,用频率减半重试:普通建树,深度超限则全部频率减半(向上取整)重建;频率越均匀树越平衡,收敛到全 1 时深度 ≤ ceil(log2(288)) = 9 < 15,循环必然终止。十几行可证明收敛的核心逻辑,质量损失实测可忽略。
容器是甜点层。CRC-32 查表加 slicing-by-4(256 项基础表配 3 张派生表,每步消化 4 字节),吞吐从 306 提到 506 MB/s;gzip 编码输出 FLG=0、MTIME=0——RFC 明确允许"无时间戳可用",输入是内存缓冲,伪造文件名和时间反而失真——XFL 仿 zlib(9→2,1→4),OS=255 表示未知。解码端完整解析 FEXTRA/FNAME/FCOMMENT/FHCRC(解析后丢弃,API 只返回字节),多成员拼接按 RFC 1952 明文接受。
差分压测:10,458 条语料与 2,500 条坏流
语料生成器种子固定、可复现,铺满 10,458 条:
| 类目 | 条数 | 覆盖 |
|---|---|---|
| A 边界尺寸 | 489 | 91 个边界尺寸(0-262144,含 65535±1、32768±1)× 全零/全FF/随机/文本 + 窗口诱导 |
| B 周期扫描 | 249 | 周期 1-1000 × 3 种尺寸 |
| C 小件 | 3200 | 0B-1KB,含 0/1/2 字节,9 种生成器混采 |
| D 中件 | 4300 | 1KB-64KB |
| E 大件 | 1700 | 64KB-256KB |
| F 特大件 | 500 | 256KB-2MB |
| G 巨件 | 20 | 2MB-10MB,含精确 10MB×2 |
生成器混采 UTF-8 中英文、JSON/HTML/CSV 仿真、稀疏位流,任务书的全清单都落了地。
每条语料跑 5 个方向,断言全部逐字节相等:
| 方向 | 断言 |
|---|---|
| inflate(node 裸 deflate) | 逐字节相等 |
| gunzip(node gzip) | 逐字节相等 |
| node 解我们 gzip 的输出 | 逐字节相等 |
| node 解我们裸 deflate 输出 | 逐字节相等 |
| gunzip(自己 gzip) | 往返相等 + CRC/ISIZE 校验路径 |
另有一份 12 语料 × 9 压缩档 × 5 方向的全档扫描盯着 levels。行为对齐不止于正路:尾随垃圾(inflateRaw 语义)忽略、多成员拼接接受、坏 FHCRC 与保留 FLG 位抛错、空流等于固定块 EOB——每条防线都有与 node:zlib 的双向对拍用例,我们抛它也抛,我们收它也收,输出逐字节相等。
坏流 2,500 条:纯随机字节喂 gunzip 700、随机 FLG/头字段 300、合法头加随机 deflate 位 300、真实流逐字节截断 200(每个前缀都必须抛错)、结构化恶意 120(LEN≠NLEN、BTYPE=3、HLIT/HDIST 越界、非法符号 286/287、距离符号 30/31 等 12 类各 10 条)、随机 CRC/ISIZE 380,再加 500 条裸随机位喂 inflateRaw 与 node 结局对拍。结果一句话:无一死循环、无一越界,与 node:zlib 的结局逐条一致。不挂死是结构保证的——解码器每步严格消费 ≥1 位(stored 块 ≥40 位),进度单调,坏流想绕圈都没有物理学依据。
抓虫实录
三条,前两条来自差分,第三条来自基准。
第一条:一个 Uint8Array 引发的静默截断。 就是开篇那条流。位级追踪显示,本该发射长度符号 270 的地方,发射了一个 8 位字面量 14——270 mod 256 = 14。LEN_SYM(长度到符号的映射表)声明成了 Uint8Array(259),而长度符号的取值域是 257..285,天生超出 8 位;TypedArray 越界赋值不报错、不进位,只静默按位截断,LEN_SYM[23] 就这样变成了 14,编码器把"长度符号 270"编码成了"字面量 14"。最阴险的是产物流依然合法:node 一声不吭地解出 "hello world",只是数据丢了。差分对拍第一秒揪出它。修法是换 Uint16Array,外加现在写死在表头的注释:"注意必须是 Uint16Array"。类型化数组的值域要在声明处交代——这一课的学费恰好是 12 个字节。
第二条:写入端的 alignByte 不是读取端的 alignByte。 修完第一条,随机数据又全军覆没:"invalid stored block lengths"。位级追踪:流的开头直接是 LEN 字节,BFINAL/BTYPE 三位凭空消失。凶手在 BitWriter 的 alignByte——我照着读取端的语义镜像实现成了"丢弃悬空位"。但写入端的对齐是补零提交:stored 块头部那 3 位是真实流内容,必须落盘成 0b00100000 这样一个字节,丢弃等于没写过。读取端 align 丢掉的是填充位,写入端 align 提交的是填充字节——同一个名字,两种语义,镜像直觉在位流的两端不成立。此后 alignByte 的文档注释里写死了这句话。
第三条:性能读数反复横跳。 调优期 deflate 的读数在 2.0 与 7.1 MB/s 之间摇摆,同一份代码同一份语料。归因实验做了三轮才定位:基准里四份 8MB 数据集共存时,GC 会把 deflate 压低 2-3 倍;TokenBuf 预分配消灭倍增拷贝的 GC 垃圾之后,残留差距全部来自测量环境本身。bench 现在把每个语料圈进独立作用域、测完释放引用,脚本注释里记了这笔账。教训:性能数字的方差先于均值值得怀疑。
数字
验收线由任务书定:inflate ≥30 MB/s、deflate lv6 ≥5 MB/s;速度按 lzbench 惯例以"原始数据量/时间"计。实测(Node 24.16 / Windows):
| 语料 8MB | inflate 输出口径 | inflate 输入口径 | deflate lv6 | node lv6 |
|---|---|---|---|---|
| 文本 | 48.5 MB/s | 22.9 | 6.0 MB/s | 21.0 |
| JSON | 159.9 | 27.7 | 10.6 | 54.0 |
| HTML | 315.7 | 28.4 | 22.6 | 66.5 |
| 随机 | 1661 | 1661 | 17.3 | 36.3 |
inflate 全语料 ≥48.5 MB/s,验收线的 1.6 倍余量;deflate lv6 全语料 ≥6.0。与 node 的绝对差距 2-5 倍,C 与 JS 的常规鸿沟——唯一例外是随机数据:node 的 36 MB/s 是纯 stored 透传,我们做完真搜索还剩 17。CRC-32 8MB 506 MB/s(node 原生约 4000,量级差来自 C 与 SIMD);gzip 全链路 6.2-21.4 MB/s,gunzip 55-397。
压缩率以 gzip 尺寸比值留档(ours/node,小于 1 表示比 node 小):
| 语料 2MB | lv6 | 全档最佳 |
|---|---|---|
| 文本 | 1.041 | 1.034(lv9) |
| JSON | 1.019 | 1.015(lv7) |
| HTML | 0.968 | 0.939(lv7) |
| 随机 | 1.000 | 双方退化到 stored |
万级语料按档聚合的几何平均:小件 0.986、中件 0.994、边界加周期 0.981、大件 1.011、特大件 1.050、巨件(含全零/全FF)0.839——整体与 node 同档打平(±1-5%),HTML/周期数据反而更小:单块动态表与 zlib 的分块策略在不同数据上互有胜负。已知让分:lv1-3 的贪婪搜索加较小的 nice,异构文本比 node 同档差 4-8%。
总账:16 文件 / 187 用例全绿,tsc --noEmit 零错误;RFC 1951 边界专项 24 项(stored 65535、窗口 32K、长度 3/258、距离 1/32768,手工造流加 node 双裁判);gzip 头字段 FEXTRA/FNAME/FCOMMENT/FHCRC 单字段各造一条、四字段全开组合、坏 FHCRC,均与 node 对拍。npm test 约 3 分钟,含全部差分与坏流,种子固定。
封存
已知限制如实入档:
- 单逻辑块:整份输入一个 fixed/dynamic 块(stored 按 65535 切片),动态表整份只建一次,异构大文件上比 zlib 的分块策略最多差约 2%;
- 无流式 API,一次性进出,10MB 语料内存峰值约 3 倍输入规模,超大文件请分块;
- 无 preset dictionary、zlib 容器、ZIP 归档——任务书范围外;
- inflate 尾随字节忽略(与 node inflateRaw 一致),严格校验请走 gunzip;
- 懒匹配策略与 zlib 不逐位相同(搜索顺序、tie-break 有差异),压缩率持平但字节流不逐字节可比。
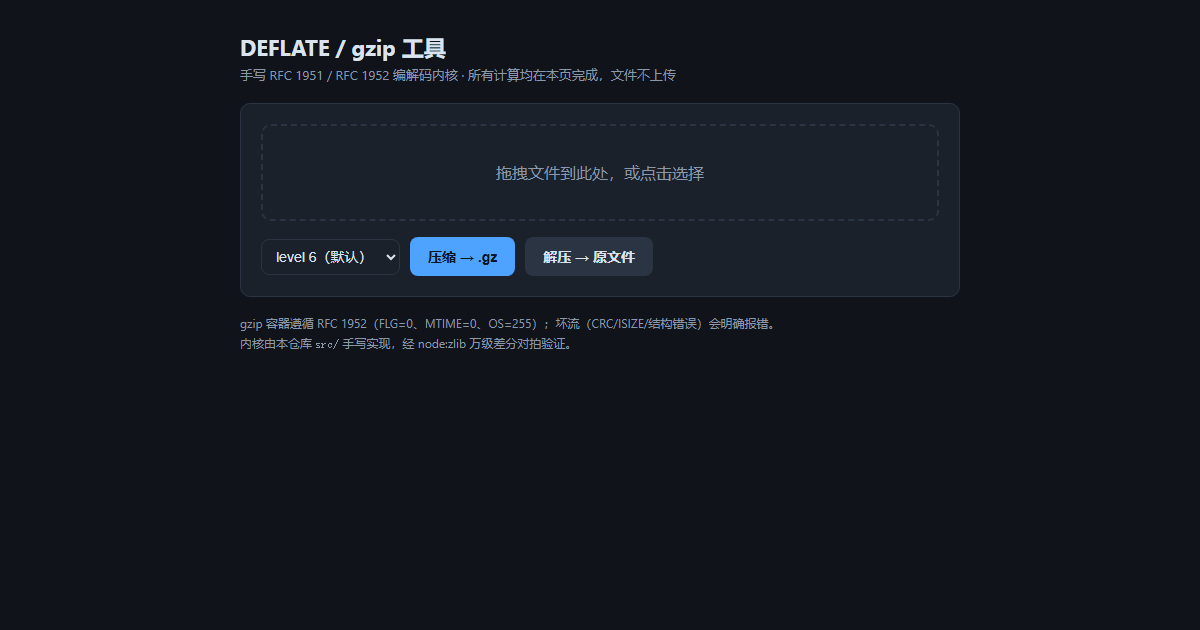
工具已上线:https://deflate-lab.pages.dev ——拖文件进去 gzip/ungzip,前后大小对比,全部在浏览器本地完成;内核就是这套零依赖实现,esbuild 单文件 21.7KB。想复核:npm install && npm test,三分钟跑完 10,458 条差分加 2,500 条坏流。
回头看,这是"零维护项目群"里成本最低的一站:规格 1996 年冻结,RFC 就是全部文档,裁判内置在运行时里,连测试 ROM 都不用找。真正的难点不在 Huffman 也不在 LZ77——它们在 RFC 里各占一两页——而在于位流这种东西不允许"大概对":错一位,要么全流报废,要么更糟,像开篇那样合法但丢数据。把"大概对"逼成"逐字节相等"没有捷径,只有差分压测这个笨办法;好在它足够笨,笨得可靠。
同一批还有两篇在路上:JPEG(ITU-T T.81,另一份上古冻结规格)和 mini-Git。前一站:《让 4.19MHz 的掌机笑起来:Game Boy 模拟器三部曲》。
继续阅读 · 相关文章
根据文章内容的语义相似度自动推荐