契约先行:冻结 contract.ts(Bus/CPU6502/PPU2C02 接口 + NTSC 常量)后,CPU、PPU、主板三个 AI 会话并行开发,主板每 CPU 周期推 3 个 PPU dot,VBlank 经 NMI 回调接线,集成日三方契约字节一致、零协商。CPU 周期数不查表、由真实总线访问次数累加,nestest 黄金日志 5003 行逐行对拍抓出 PLA/PLP/RTI 三个周期 bug,blargg official_only "All 16 tests passed"(43,721,812 周期),405/405;PPU 的 16 位移位寄存器在流内与停摆期是两种 reload 语义,26 条逐像素金测,211/211;主板补上 MMC1 极性、2A03 帧计数器与两种 blargg 结果协议,sprite_hit 11/11,croom 浏览器 59.4fps 可玩。整机 116/123:修复轮 1 用契约 v1.1 的访问级 PPU 同步把 17 项压到 7 项;修复轮 2 用受控实验杀死了我自己提出的两个假设,最终根因收敛为「单一全局 nmiDelay 无法同时满足 05 与 06/08」——NMI 通路的锁存与输出没有解耦。剩余 7 项作为已知限制定稿,116/123 在外部 CPU 满载下仍逐项复现,48KB 单文件已部署。
按下「打开 ROM」,选了 Concentration Room——一个 GPL 协议的免费 homebrew。标题画面浮出来,Start,进局,方向键移光标,A 键翻牌:樱桃卡面翻开,配对成功。页面左下角一行绿色小字:59.8 fps。
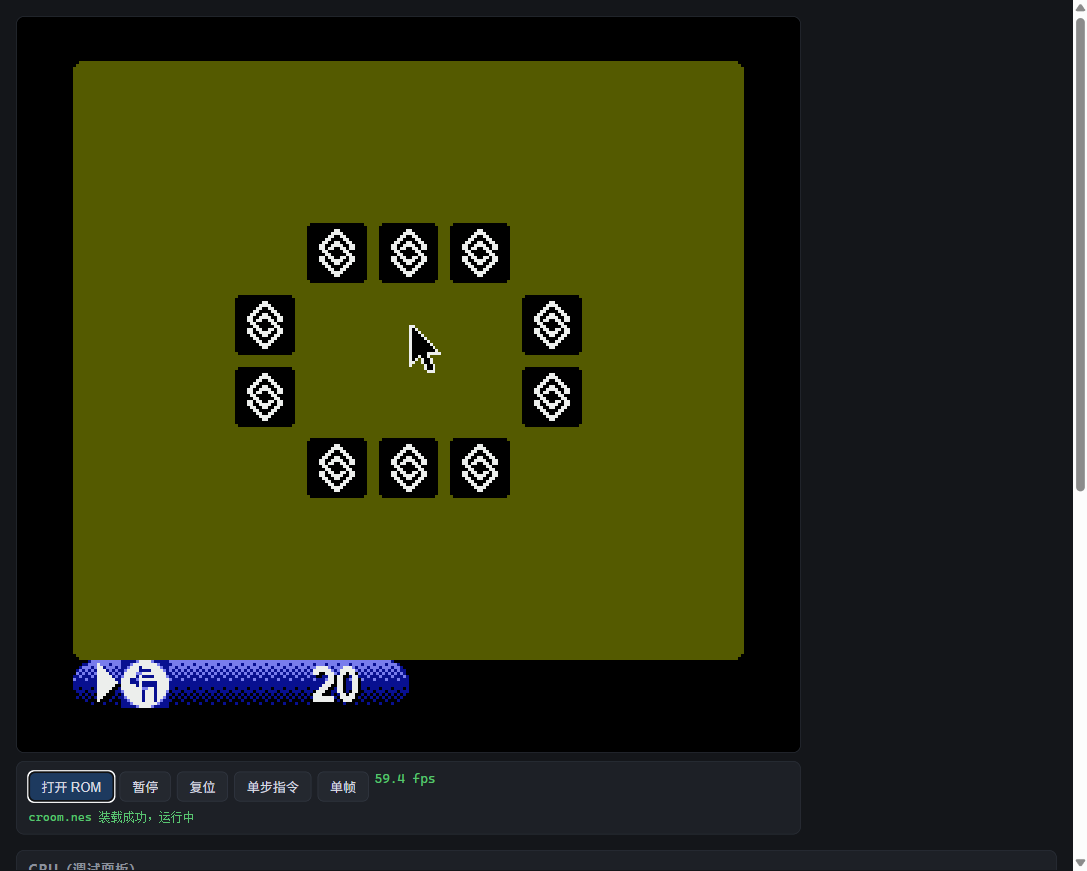
我盯着那行数字看了很久。它意味着三件事同时成立:一块 1983 年的 CPU 在按正确的周期数执行指令,一块 PPU 在按正确的 dot 出像素,一块主板把两者按「每 CPU 周期 3 个 PPU dot」的节拍焊在一起。
而这三个部件,是三个互不知道彼此存在的 AI 会话各自从零写出来的。它们第一次见面,是在集成日。
为什么是 NES
这条「从零造机器」的线走到第三站了:nand-computer 从零写软件栈,cha-lang 造了语言,上一篇文章的电路仿真器把 Hack 计算机「画」了出来。但前两台机器的 ISA 都是自己定义的,对错只能自己证明。
NES 不一样。它是一台真实量产过、卖了几千万台的机器,硬件规格 1983 年冻结,四十年没人改过一行。这意味着两件奢侈的事:
- 规格永不变,完工即封存,零维护;
- 裁判是现成的,而且是化石级的:nestest 黄金日志、blargg 测试 ROM 全家桶,社区攒了二十多年,每一项测试都有明确的通过判据。
测试标准不用自己写的项目,错了也怪不了别人。
三部曲与冻结契约
总纲把机器拆成三部,开工前先把 contract.ts 写死:Bus、CpuState、CPU6502、PPU2C02 的接口,加上 NTSC 时序常量。三个 AI 会话并行开工,谁都不许改契约一个字节;发现缺陷写进各自目录的偏差记录,不许现场协商。
| 部 | 职责 | 测试 |
|---|---|---|
| nes-cpu | 6502 全指令集、寻址模式、中断、周期精确语义 | 405/405 |
| nes-ppu | 背景/精灵渲染、滚动、调色板、寄存器语义 | 211/211 |
| nes-main | iNES/mapper/总线/NTSC 主循环/Web UI + 三部集成 | 108/125 |
第一、二部互相零依赖,各自对着假总线开发。接线是第三部的活:每执行一个 CPU 周期,把 PPU 的 dot 推 3 格;PPU 在扫描行 241 置起 VBlank 时,经 nmiCallback → cpu.nmi() 把中断线拉起来。
集成日是这样度过的:把两部的源码拷进主板仓,git diff 校验三方 contract.ts 字节一致,然后跑全仓测试。零协商。契约冻结的价值要到这一刻才兑现——这套打法在电路仿真器项目里验证过一次,这是第二次。
当然,契约不是完美的。集成时发现两处完备性缺口:getFramebuffer 没注明像素格式(赌 RGBA,赌对了);更实质的是缺 CHR 写通路——CHR-RAM 游戏开机要用 $2007 把字模写进 CHR 区,契约里 PPU 只有 setChrReader。后果很具体:2005 系 blargg 测试壳全部引导失败,CHR-RAM 游戏直接不工作。解法是给 PPU 加附加接口 setChrWriter,主板装配时把卡带的写函数注入,不动契约任何既有签名,二期转正进 v1.1。
6502:周期不是查出来的,是记出来的
第一部最核心的决定:周期数不查表。每条指令拆成一串微操作,read8/write8 各恰好一个 CPU 周期,周期数由真实总线访问次数自然累加。收益是结构性的——那些文档里一行小字带过的「哑读」,零页索引加索引前的读、abs,X 跨页修正的读、JSR 栈内部的读,全都是寻址函数里真实发生的总线访问,想漏都漏不掉。而哑读和 RMW 的「读-写旧值-写新值」双写,恰恰是 mapper 兼容性的命门。
最容易做错的三条指令,形状全被黄金日志钉死:JSR 压栈压的是返回地址-1;PLA/PLP 的第 3 周期是对旧 SP 的栈哑读,不是可以省略的准备动作;RTI 的末周期就是拉 PCH,没有 RTS 那个「在返回地址-1 处再读一次」的收尾。文档周期表里每个 cycle 都有名字,没有一个是装饰。
最终裁判是 nestest 黄金日志:官方区 5003 行,逐行比对 PC/A/X/Y/P/SP/CYC 七个字段,100% 一致。它抓出了三个生成式测试和语义测试都没发现的 bug:
| 黄金日志行号 | bug |
|---|---|
| 73 | PLA 少了栈哑读:3 周期,应为 4 |
| 104 | PLP 后 P 的 B 位语义错误:拉栈时 bit4/bit5 都不入库 |
| 935 | RTI 多了收尾哑读:7 周期,应为 6——它和 RTS 的第 6 周期形状不同,不能想当然类推 |
中断系统用「每周期采样 + 两个历史槽」的模型:NMI/IRQ 线每个总线周期采样一次,普通指令看倒数第二周期的采样,分支看末周期。于是 CLI/SEI 延迟一条、PLP/RTI 立即生效,全都不用给指令打补丁,从模型里自然涌现。分支劫持这种「中断线在指令第 N 周期才拉高」的场景很难造,测试用了触发总线:在指定地址被读取的瞬间调用 cpu.nmi()——末周期触发压旧 PC、倒数第二周期触发压目标 PC、非分支末周期触发推迟到下一条之后,三个时序各有断言。
对拍失败时先怀疑夹具,再怀疑内核。中断测试的向量落点如果是 0x00(等于 BRK)会假失败,得在向量目标处种 NOP;夹具的前导 LDX #sp 会覆盖 X,装载指令必然改 N/Z——「精确 P + 精确寄存器」的用例要么选值避开冲突,要么只断言相对变化。
第三方验收交给 blargg 的 official_only:测试输出一行 "All 16 tests passed",全程消耗 43,721,812 个周期,0.8 秒墙钟跑完。单帧 0.231ms,约 129 倍实时。405 条单元测试全绿。
PPU:逐像素的官司
PPU 是一部每帧跑 89342 个 dot 的状态机:扫描行 241 的 dot 1 置 VBlank,pre-render 行清三个标志,奇数帧还要跳过一个 dot。它被 211 条测试钉死,其中最狠的是金测——合成一个背景图案 + 四象限属性 + 四只精灵(翻转/优先级/behind)+ 组合滚动的场景,26 条逐像素断言,其中 3 点完全硬编码 RGB;同输入跑两遍,帧缓冲逐字节相等。
开发中最有意思的发现:16 位移位寄存器的 reload 有两种语义。背景渲染用两个 16 位移位寄存器,高 8 位输出当前 tile,低 8 位预取下一个,每 8 个 dot 装填一次。直觉写法是统一左移顶入——结果每行 x=8-15 全黑,打印移位寄存器才发现 tile1 被挤掉了:像素时钟和 fetch 时钟是两个节拍。
// 流内(dots 8-248/256):像素时钟每 dot 左移,tile1 已被移位流顶入高 8 位
sh = (sh & 0xff00) | latch
// 停摆期(dots 328/336 行尾预取):寄存器冻结,低 8 位要手动顶入高 8 位
sh = ((sh & 0xff) << 8) | latch
同一个装填动作,在「流内」和「停摆期」是两种形状。统一用 <<8 | latch,可见行内把刚顶入的 tile1 挤掉;统一用 |=,pre-render 预取的 tile0 又会丢。按 dot 区间区分之后,逐像素金测才全绿。
滚动是 loopy v/t/x/w 四个寄存器的舞蹈:2006 第一次写高 6 位且 bit14 不可写,第二次写完 v=t。$2007 的缓冲读另有一层:非调色板地址首读返回 stale,第二次才命中;调色板直读,但内部缓冲被命名表镜像值污染——下次读非调色板地址会先吐出这个灰值。还有一件小事值得记:reset 后第一帧必然黑屏,可见行在时序上跑在 pre-render 行之前,上电首帧没有任何预热,移位寄存器是空的——所有渲染测试统一跑 2 帧,不是手滑,是与硬件上电行为对齐。
顺带一个反直觉的命名:vertical mirroring 的页选择位是地址 bit10,适合横向滚动游戏——这个名词描述的是排列方向,不是滚动方向。
性能从初版 6.4ms/帧压到 1.57ms,靠查表式色彩合成、Uint32 单写帧缓冲、镜像映射预计算和热路径手动内联。最后一步是 V8 内联预算不可靠时的无奈之举,代价是渲染逻辑双写——靠头注释声明两处必须同步修改,金测同时覆盖两条路径兜底。
主板:blargg 全家桶与两种结果协议
主板是最像「胶水」的一部,却攒了一堆只有真机才有的细节:
- MMC1 的 PRG-RAM 使能位极性初版写反。对 nesdev wiki 核实:MMC1B 语义 R3 bit4 是 0=使能、1=禁用,单元测试当场抓出;
- 2A03 的帧计数器不是音频,是 CPU 侧定时器。音频 APU 压根没实现,但 4017 的帧计数器必须先就位——blargg 2005 系测试壳的 sync_apu 例程拿它当时间基准,没有它测试壳连引导都过不去;
- NTSC 一帧平均 29780.5 个 CPU 周期,不是整数。逐帧累加再取整会因 .5 舍入漂移,测试抓出后改成
round(frameIndex × 29780.5),差分自然形成 29781/29780 交替; - 帧边界落在指令中间时,整条指令执行完、余量结转到下一帧(7 周期长指令的测试验证);OAM DMA 的 513 个附加周期由 CPU 侧记账;未映射区读取返回最后一次总线值(开总线残留),手柄读返回
0x40 | bit; - 调试面板显示扫描行/dot/VBlank,但绝不读 $2002——读它会清 VBlank 标志、污染运行态,面板数据全部由机器侧 dot 计数推导。
blargg 测试 ROM 还藏着一个协议坑。新协议用 6000 不写,结果码以蜂鸣次数报告,1=通过。任务书原文写的「0x01 成功」是老约定,实现时对着官方 readme 核实修正——同一个 blargg,两套判定,自动化读错协议就是全红。还有一类的判定本身就有趣:power_up_palette 跑出结果码 2,含义是「与 blargg 真机不一致」,这恰好是模拟器的预期结果,判过。
集成还动了两处跨会话补丁:0xBF(LAX abs,Y)的寻址模式被写成 'abx',一字笔误,黄金日志第 5482 行抓获——官方测试不覆盖非官方指令,所以第一部的 405 项测不到它;RMW 组合族 42 个 opcode(SLO/RLA/SRE/RRA/DCP/ISB)原版是「双写原值」占位,集成侧补全真实语义,第 5841 行的 DCP 分歧由此消失。8991 行全量对拍兜底。
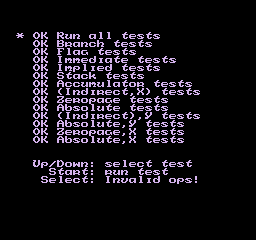
整机的成绩单。nestest 图形模式,Start 进全部测试分类,14 行 OK:
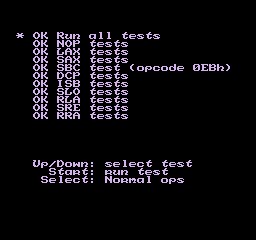
Select 切到非法指令菜单,11 行 OK——LAX、DCP、ISB、SLO、RLA、SRE、RRA 全过,上面那两处集成侧补丁的直接验证:
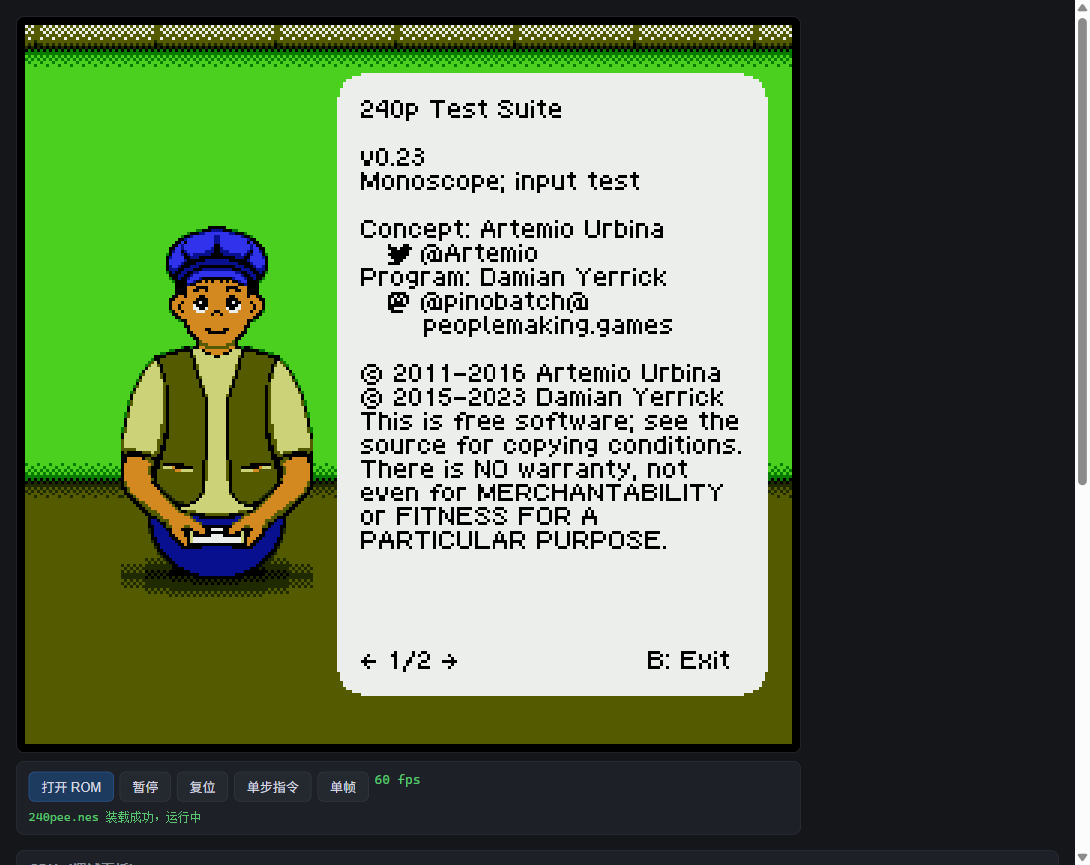
sprite_hit 测试 11/11 全过,精灵 0 命中的全部语义——翻转、边角、裁剪、与背景使能的组合——都对。240p Test Suite 是 UxROM + NES 2.0 + CHR-RAM 的实弹,它以 60fps 跑起来,等于 setChrWriter 那个契约缺口的实战验证:
数字
| 项 | 值 |
|---|---|
| nes-cpu | 405/405;nestest 官方区 5003 行 100%;blargg official_only "All 16 tests passed"(43,721,812 周期) |
| nes-ppu | 211/211;26 条逐像素金测断言;1.57ms/帧 |
| nes-main | 116/123(7 项已知限制);sprite_hit 11/11、sprite_overflow 5/5;croom 59.8fps、240pee 61.6fps |
| CPU 单帧 | 0.231ms,约 129 倍实时 |
| 性能 | 中位批均 9.93ms(独立 bench 套件,不参与正确性 gate) |
| 产物 | dist/index.html 48KB 单文件(已部署) |
修复轮 1:接口不够,那就加接口
第一次修复轮的起点是 108/125。核心症结在集成方式:CPU 原子执行整条指令,PPU 只能在指令边界被批量推进,于是 $2002 读看到的永远是「指令开始那一刻」的 PPU 快照——VBlank 置位、NMI 输出、精灵溢出这些 dot 级事件全被抹平了。
解法是契约 v1.1,只做加法:Bus.onAccess?(cycleInInstruction, cyclesAbsolute) 让 CPU 在每次总线访问前回调,机器把 PPU 惰性喂到该访问所在的那一个 dot;另加 setChrWriter? 把 CHR 写通路转正。参数刻意用两个数字而不是对象载荷——热路径每帧五万次调用,对象载荷实测引入 30ms 级 GC 停顿。
结果:17 项失败压到 7 项。02-vbl_set_time、03-vbl_clear_time、06-suppression、08-nmi_off_timing、sprite_overflow 3.Timing/4.Obscure、vbl_nmi_timing 2/4/5/6 全部转绿,sprite_hit 11 项零回退。同时修掉了一个更隐蔽的问题:之前「报告绿、实跑红」是 vitest 文件并行导致 CPU 争抢(perf 从 8ms 漂到 39ms),串行跑文件之后确定性才成立。
修复轮 2:两个假设被测量杀死
我把剩下的失败归成两簇,提了两个假设:一是帧边界按 CPU 周期量化、丢了亚周期余数;二是 onAccess 丢弃了 cycleInInstruction、采样点恒定偏 1 个 CPU 周期。两个假设都有代码证据,看起来都很像。
然后它们被数据杀死了。
第一个假设:改前改后各测一次相位差序列——逐位相同,稳定段恒定 +1/帧(这本来就是硬件行为);而且改动还破坏了 2 项原本通过的测试,立即回退。第二个假设:以 05 的落点表为裁判,读采样放在指令首 dot 和末 dot 各跑一次——两张表逐项相同,sync_vbl 的自校准把相位差吸收了。
真正有用的数据来自一组受控诊断:
| 实验 | 结果 |
|---|---|
| VBlank 置点从 (241,1) 移到 (241,4) | 05 落点表不变 |
| $2002 采样相位 首 dot / 末 dot | 落点表逐项相同 |
| nmiDelay = 1 | 05 转折在 04 |
| nmiDelay = 2 | 05 转折在 05 |
| nmiDelay = 3 | 05 转折在 06(期望 03),06/08 需要它才过 |
结论收敛成一句话:单一全局 nmiDelay 无法同时满足 05 与 06/08——NMI 通路的「锁存」与「输出」没有解耦,延迟应该随「使能时机 × dot」分段,而不是一个常数。这不是「结构性不可解」,是一个可复现、可测量的模型粒度问题;但它也确实不是这一轮能顺手补上的东西。
能被数据杀死的假设,比能编故事的结论值钱。这一轮没换来任何一个新绿的测试,但把「为什么修不动」从猜想变成了三张表。
现在的状态
116/123,固定 7 项失败,全部写进已知限制:
| 项 | 性质 |
|---|---|
oam_stress | 需要 secondary OAM 直通子系统,独立工程量 |
cpu_timing_test | 4 万帧长时序矩阵,墙钟成本问题,非正确性 |
05 / 07 / 10 / vbl_nmi_timing 7 / 综合 | NMI 输出延迟的全局常数权衡(上表) |
连续三次全量、其中一次后台跑满 CPU 的负载下,失败集逐项一致。性能基准移出 npm test 进独立 bench 套件——墙钟断言不该当正确性 gate。
从零造机器
nand-computer 的软件栈、cha-lang、电路仿真器,再到这次的 NES——这条线的共同点始终没变:契约先行、并行开发、拷贝式集成,对拍至上的验收。
对拍依然是最便宜的天使投资人。nestest 黄金日志 30 秒定位三个周期 bug;blargg 测试 ROM 抓住契约缺口、协议误读和一字笔误;连 NTSC 帧周期的 .5 舍入都有一条测试盯着。自己定义规格的项目,裁判得自己造;面对 1983 年冻结的硬件,二十多年的社区积累把裁判提前请好了——这大概才是模拟器项目最大的奢侈。
Demo:https://nes.adcakeyuan.top · 源码:https://github.com/huqinyuan923-hue/nes-emu
前一站:《把一台计算机画出来:电路仿真器三部曲》——同一套"契约先行、三会话并行"的打法,第一次被验证的地方。
继续阅读 · 相关文章
根据文章内容的语义相似度自动推荐